合成データとは?~今さら聞けない!基本の『キ』

- この記事はこんな方にオススメ!
-
- 合成データとは何か、言葉の意味をざっくり知りたい方
- 合成データがなぜ注目されているのか、どういうときに活用されているのかを理解したい方
- データ量不足やプライバシー保護の観点で分析が難しいデータベースを持っており、どうにかして分析できないか手段を検討中の方
近年、AI開発やデータ活用の高度化に伴い、注目を集めているのが「合成データ」(英語表記Synthetic Data:シンセティックデータ)です。
合成データとは、一文でまとめると「実在する元データの統計的分布・特徴を維持したまま作り上げた、実在しない仮想のデータ」を指します。
・・・はて?どういうこと?となった方も多いのではないでしょうか。
筆者も数か月前に初めてこの説明を聞いた際は、「よくわからない...」とうまく呑み込めませんでした。その後社内のデータサイエンティストたちに何度も質問しながら理解を深めるうちに、その活用の幅広さとマーケティング領域での有用性に強く興味を持つようになりました。
そこで本記事では、合成データがなぜ必要とされるようになったのか?どういうシーンで活用されるのか?どういう視点で評価するのか?といった基本知識をなるべく専門用語を使わずにご紹介していきます。
合成データ=実在するデータを元に作った「実在しないデータ」
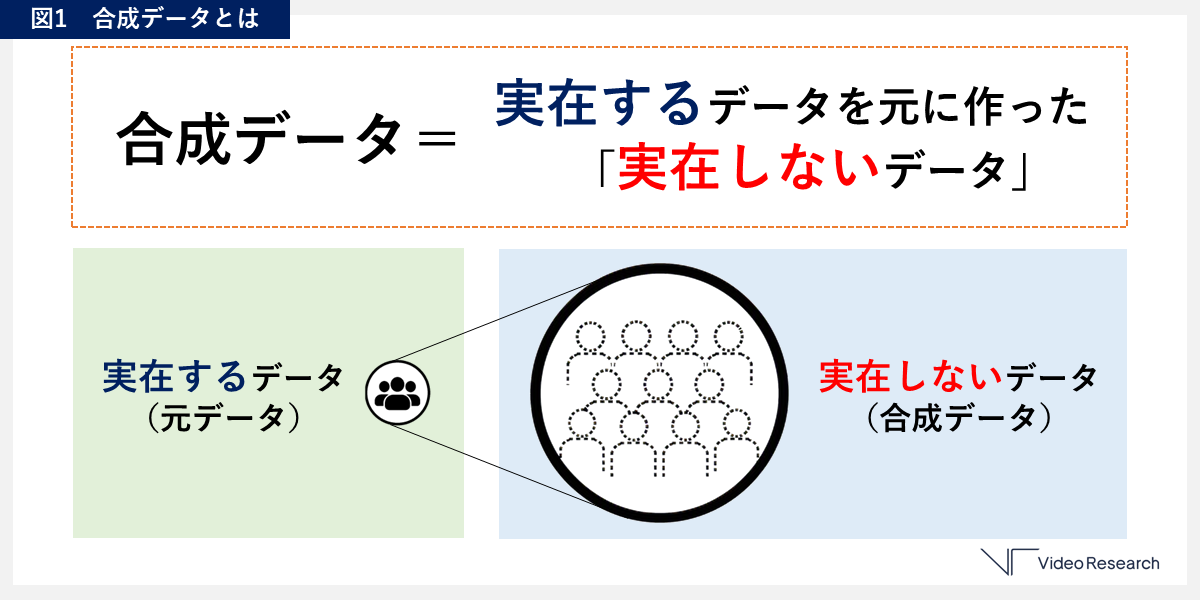
合成データとは、「実在するデータを元に作った実在しないデータ」をさします。
とんちみたいな文章に見えますが、こう考えるとわかりやすいです。
たとえば、とある病気Xに関する検査の結果や処方内容がまとまったデータが全国の病院にあるとします。これらのデータを1つにまとめれば、その病気の昨今のトレンド・傾向や新たな治療方法の発見につながる可能性が考えられますよね。
ですが、病気Xに関するデータを別の目的で収集・共有・分析するには、プライバシーへの慎重な配慮が必要になることはだれしも容易に想像できることでしょう。
では、この病気に関する「実在する」患者データの特徴は維持したまま、「実在しない」別人のデータとして作り直せるとしたら?このような考え方で作られたのが、合成データです。
実際の合成データはこんな感じ
では、「実在しない」別人のデータはどうやって作るのでしょうか?ここからは合成データを生成する際の大きな2つのポイントをご紹介します。
合成データの作り方①:実在するデータと、「統計的な特徴が似る」ように作る
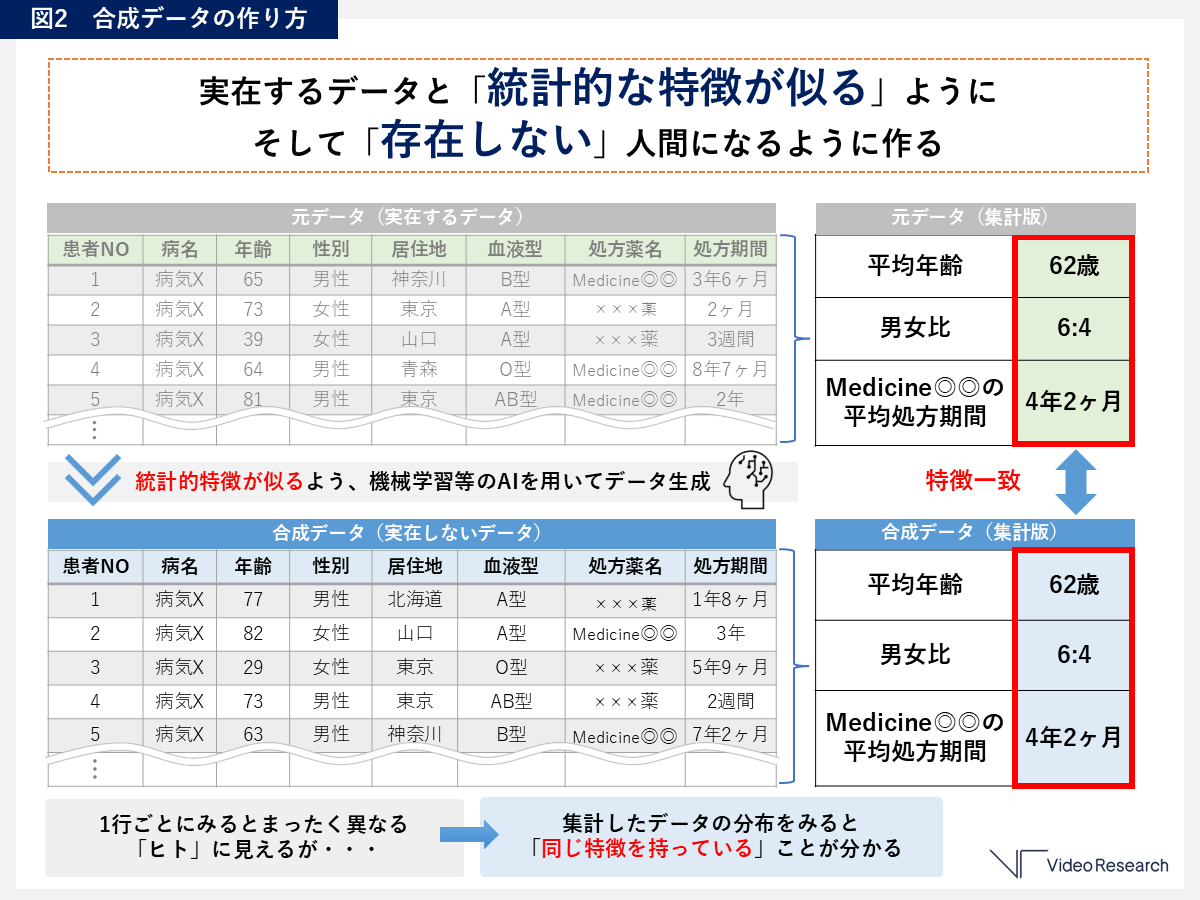
1つ目のポイントは、「統計的な特徴が似る」という点です。
統計的特徴とは、足し上げた合計値や平均値、年齢の分布など「何らかの集計をした結果」のことを言います。【図2】の左上にある表は、病気Xの患者の年齢や性別、居住地、血液型、そして処方されている薬の名称とその処方期間がまとまったとある病院のカルテ情報=実在するデータです。
これを元データとし、合成データを作ると左下のようになります。
このとき、合成データ上の年齢や処方期間は適当に生成しているのではなく、
・平均年齢を集計したら元データと同じく62歳になるように
・男女比を集計したら6:4になるように
・Medicine◎◎の平均処方期間を集計したら4年2か月になるように
統計的特徴が似るように調整しながら1行ずつデータを作り上げていきます。
合成データの作り方②:実在する人間としては「存在しない」ように作る
2つ目のポイントは、実在する人間としては「存在しない」ように作るという点です。【図2】の左上、元データでは患者NO.1~5の方は"実際にいる人"ですが、左下、合成データ上の仮想NO.1~5の人は"実際にはいないヒト"として生成されているので1レコードずつ見比べてみても全然違う"ヒト"に見えますよね。
こうすることで、合成データは"実際にいる人たちに近い状態"を作り出しながらも患者様の"実際のカルテ"は使用せずに病気Xに関するさまざまな研究・分析を行うことを可能にするのです。
※【図2】では例として5行(人)分だけ記載しましたが、実際には何十万、何百万の合成データを生成しますので実務では人間が1行ずつデータを書き換えていくのではなく、機械学習等のAIを用いて高速でデータ生成していくのが一般的です。
また、【図2】では平均値などを元データと同じ値で示しています。実際には、利用目的に応じて複数の統計的特徴や項目間の関係性をどの程度再現できているかを評価しますので、まったく同じ値になることが絶対条件ではありません。
生成AIとの違い
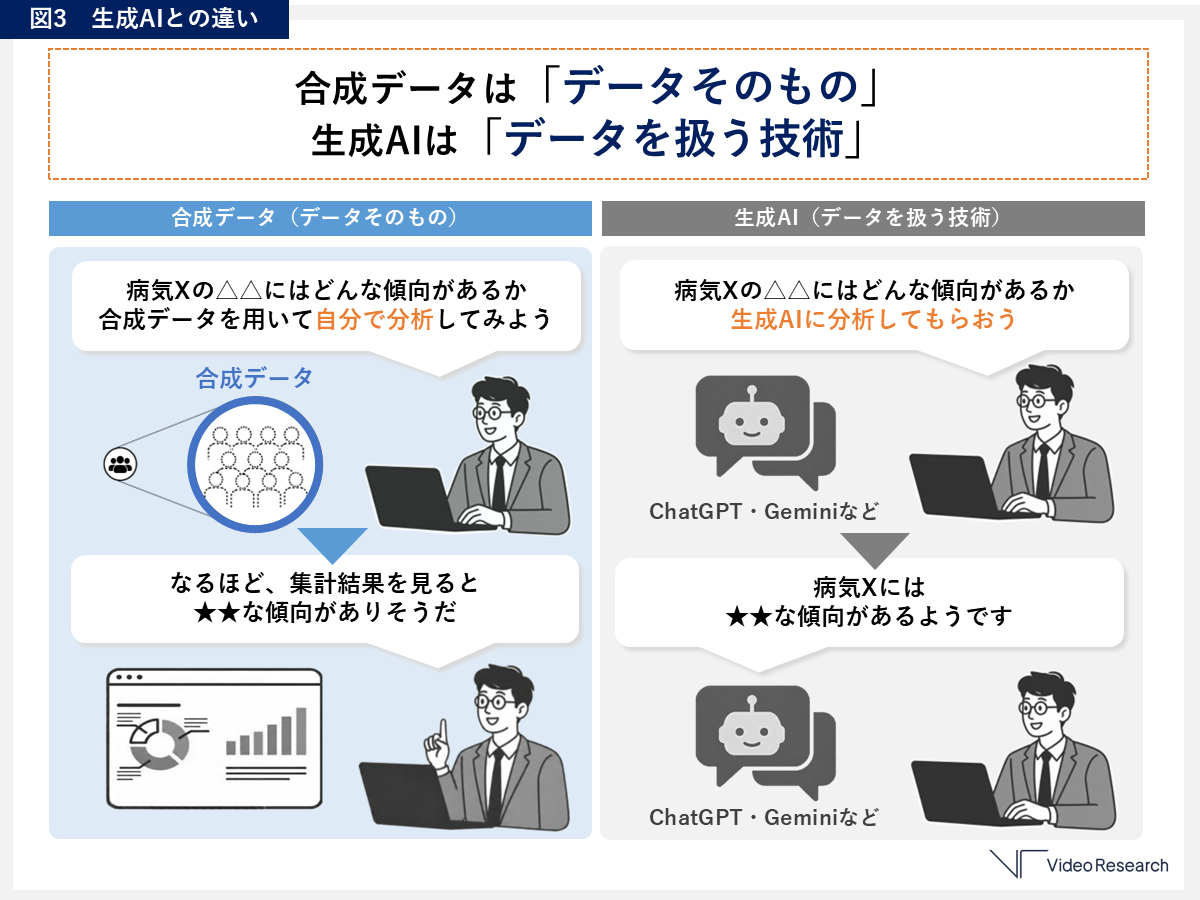
「実在しないデータ」「実在しない"ヒト"」を生成する、と聞くと、ChatGPTやGemini、Copilot、Claudeなどの生成AIやLLM(大規模言語モデル)を連想する方もいらっしゃるかもしれません。
合成データと生成AIの違いは、データそのものか、データを扱う技術かという点です(【図3】)。
合成データ自体は、それだけあっても何か新しいものは生まれません。そこから人間なり、別のシステムやAIなりが手を加えることで新しい価値を創造します。言い換えると「合成データを用いて生成AIが分析を行う」というのもありえます。
一方、生成AIは、皆さんも普段使っている通りで話しかければ自分でネット上や自分が添付したファイルなどからデータを探して分析してくれたり、その分析結果をプレゼン資料として新しく作ってくれたりと自ら新しい価値を創造してくれます。
一見すると似ているようにも見えますが、立ち位置が違うのです。
どうして「実在しないデータ」を作る必要がある?求められる理由と想定活用例
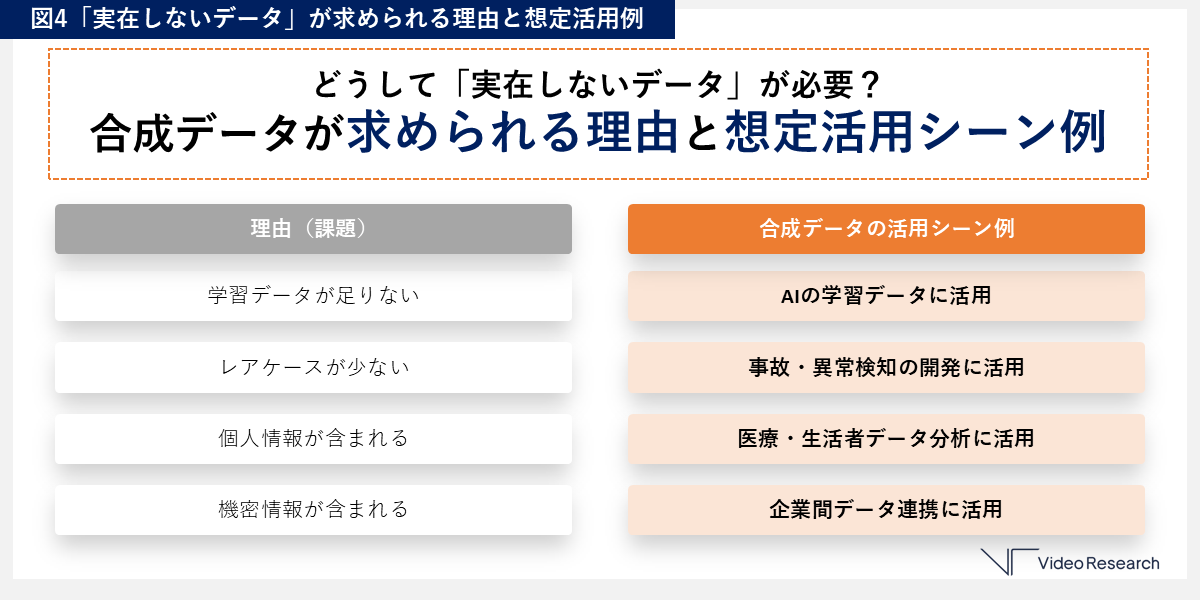
なぜ「実在しないデータ」が求められるようになったのでしょうか。それにはいくつかの理由があげられます。
―理由①:実在するデータだけだと「データ量が足りない」⇒AI学習活用
LLM(大規模言語モデル)をはじめとする生成AI、機械学習などAI領域の発展には、精度を上げていくためのトレーニング用のデータ=いわゆる学習データが不可欠です。ですが、AIの急速な発達に学習データ量が追い付かなくなりつつあると言われており、実在するデータでは足りない部分への補完に合成データの活用が進んでいます。
―理由②:実在するデータだけだと「欲しい事例が少ない」⇒事故や異常検知に活用
合成データは"ヒト"の生成に限りません。例えば「とある工場で、約100万回に1回製造機が起こす欠陥」のような現実世界ではめったに発生しないレアケースの場合、実在するデータ自体は多くあっても特定の事例に限るとデータ量が足りないこともあります。こんなときにも合成データでの補完が期待されています。
―理由③:実在するデータは「個人情報」⇒医療・生活者分析に活用
病気Xの研究例のように、分析したいデータが個人情報の場合、本人の同意・許諾が必要になります。現実的に全員に許諾を取るのが難しいケースなどで、合成データでの代替分析が試みられています。
―理由④:実在するデータは「機密情報」⇒企業間データ連携に活用
理由③と似ていますが、例えば企業が外部には提供したくない営業上の機密を含む情報と、他社が保有するデータを掛け合わせて分析を行いたい場合に、合成データに置き換えることで、実施を可能にします。
③④が理由の場合データベース内の複数の項目(カラム)のうち、個人情報や機密情報に絡む一部のみを合成データに置き換えるケースもあり、これを「部分合成データ」と呼びます。(⇔すべて合成されているのが「完全合成データ」)
合成データを作る・使う上での評価ポイントは?
通常、本物から疑似的に何かを作った時はその評価方法として「本物とどれだけ近いか?」という観点がよく語られます。たとえば天然真珠からフェイクパールを作った場合は「天然真珠と比べて、フェイクパールの輝き方はどれくらい天然真珠に近いか」といった具合です。
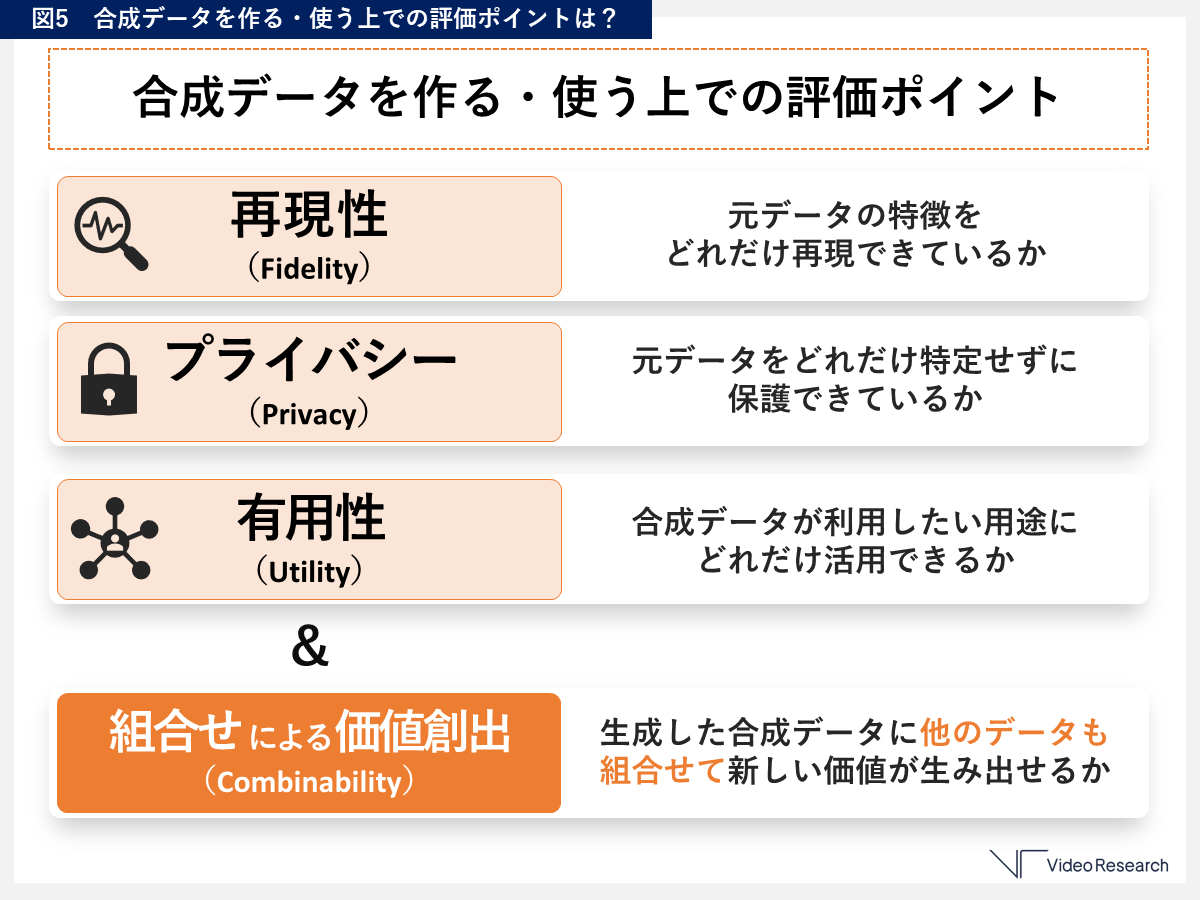
ですが、合成データは1行ずつみると「実在しない」ため本物=「実在する」元データと比べた評価ができません。そこで、以下の3つの観点を用いることが多いです。
再現性(Fidelity)・プライバシー(Privacy)・有用性(Utility)の3観点
再現性(Fidelity)は、合成データがどれだけ「元データと統計的な特徴が同じになるよう再現できているか」という観点です。合成データは元データの代わりに使うものなので、年齢分布や特定商品・サービスの利用率などが集計した結果となるべく同じになったほうが使い勝手がいい、というのは想像に難くないでしょう。
プライバシー(Privacy)は文字通り、元データ上で「実在している」方々が特定されないように合成データを生成できているか、という点です。特に個人情報保護のために合成データを利用する際に重要視されます。
有用性(Utility)は、合成データを活用することでビジネスや研究などに実際のところどれだけ役立ったか?という点です。例えば合成データを「とある工場における欠陥品発生を予測する生成AI」の学習に用いた場合、その学習結果として得られたAIによる予測がどれだけ実際の欠陥品発生防止に役立ったか?がその評価観点となります。
組み合わせる(Combinability)ことで新たな価値が創出できる
上記の3つに加え、多様なメディア・生活者データを保有するビデオリサーチでは4つ目の観点として「組合せによる価値創出」にも着目しています。
例えば合成データにWEBアンケートで聴取した「実在する」人の回答データを組み合わせることで特定商材のペルソナ像を深掘りしたり、デジタル広告の媒体レポートのような別の企業が出した統計レポートを組み合わせることでクロスメディアでの広告効果を算出するなど"合成データ×◎◎"の組み合わせにより、これまで実現しえなかったことができるようになるでしょう。
(詳細は後述)
合成データ利用時の留意点
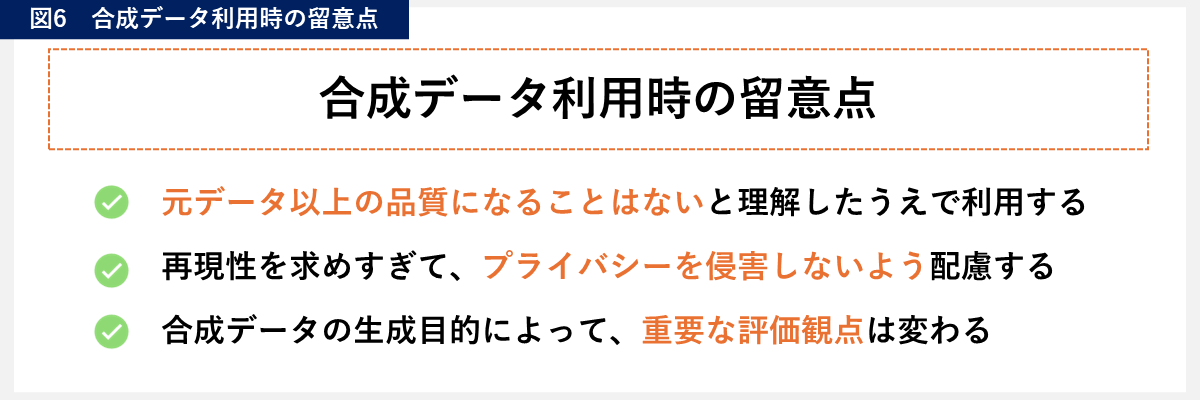
合成データを利用したり、専門会社に依頼して生成してもらう際には、以下に留意しましょう。
留意点①:元データ以上の品質になることはないと理解したうえで利用する
合成データは、元データから生成します。言い換えると、元データにないものは生成できませんので「元データには年齢情報がないが、合成データには年齢を入れて」といったオーダーは通りませんし、元データの統計的特徴を再現するのが合成データなのでサンプリングの仕方等で補正をかけたとしても元データの偏りを合成データで完全に解消することも難しいといえます。
つまり、合成データ生成時には「元データの品質」も問われるということです。
留意点②:再現性を求めすぎて、プライバシーを侵害しないよう配慮する
合成データが元データになるべく近くなるよう、再現性を高めようとすればするほど、1行ずつ見た時でも元データに「実在している」人に近い内容になっていきがちです。再現性とプライバシーは相互関係にあると言え、データ生成時には慎重な配慮が求められます。
留意点③:合成データの生成目的によって、重要な評価観点は変わる
前述の通り合成データは「元データの統計的な特徴を再現する」ものですが、その特徴はあらゆる角度から再現をしているとは限りません。
例えば「10代と20代では病気Xの罹患にどんな傾向の違いがあるのか」という分析が目的で合成データを生成するなら【10代と20代の比率】という特徴が合うようにしますし、「何歳になると病気Xの罹患割合が増えるのか」という分析が目的なら【1歳刻みでの年齢分布】という特徴が合うようにするでしょう。
何がしたいのか、という目的をあらかじめはっきりさせたうえで合成データを生成することが肝要です。
広告やマーケティング領域ではどんな活用が想定される?
合成データを活用した「仮想のパネル」=バーチャルパネルによる未来像
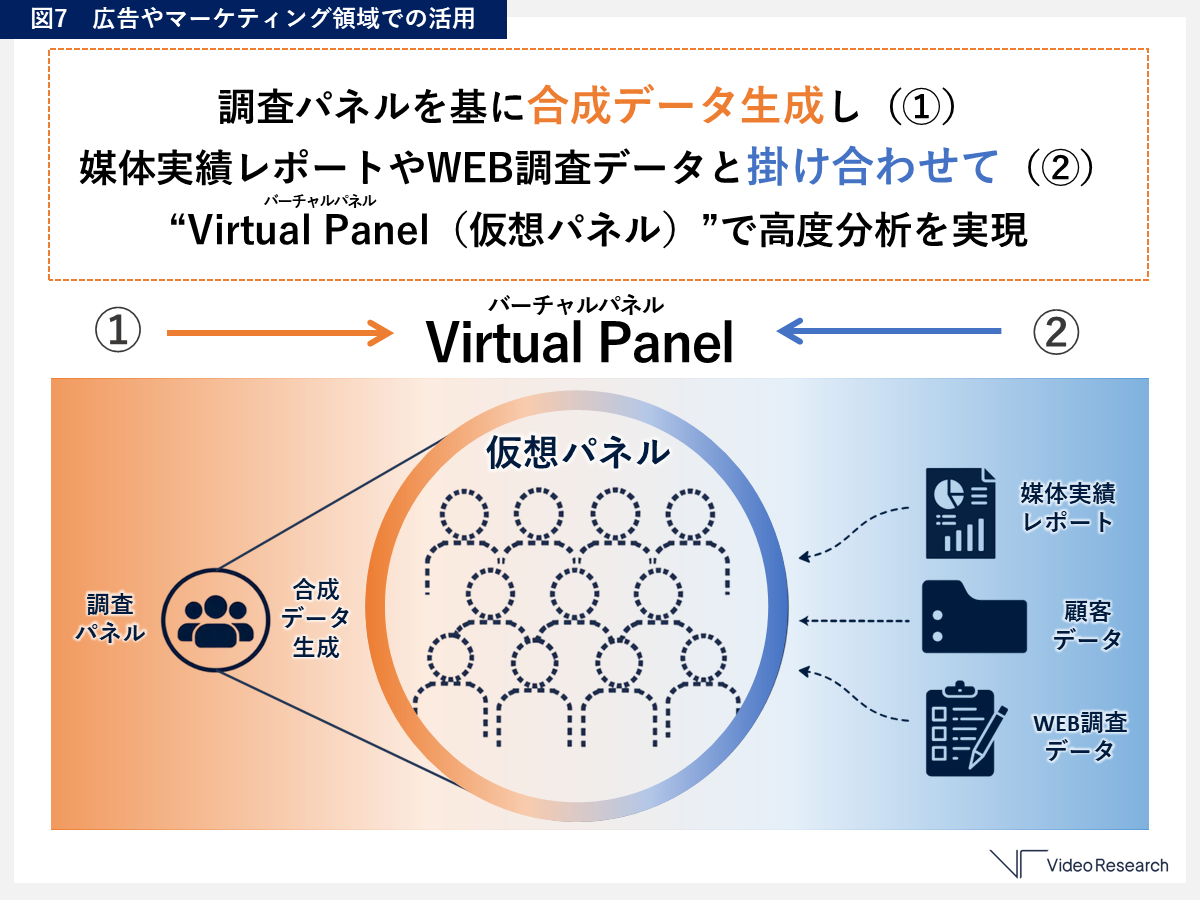
最後に、ビデオリサーチにおける合成データ生成技術を活用した取り組みもご紹介します。
テレビCMやデジタル広告をはじめとするクロスメディアでの広告コミュニケーション効果の可視化や市場/顧客理解を深めるマーケティング分析を行うにあたり、Cookie規制などのプライバシー配慮のため「本当は異なる企業間で保有するデータをID連携することで複合的に分析したいが、できない」というケースが多く起きています。
そこで、テレビ番組・テレビCMの視聴状況や動画配信プラットフォームの利用状況を取得している当社の「テレビ視聴率」調査パネルを基に合成データ生成を行います。(図7-①)そこに各社が保有するデジタル広告の出稿実績レポートやターゲットの興味関心属性データをデータフュージョン技術等で掛け合わせる(図7-②)ことで、仮想的にシングルソース化するバーチャルパネル(Virtual Panel)を構築し、さまざまな分析への活用を目指しています。
※テレビ番組・テレビCMの視聴状況は「テレビ視聴率」、動画配信プラットフォームの利用状況は「STREAMO(ストリーモ)」にて取得しています。
テレビ×デジタルなどのクロスメディア効果検証や顧客理解の深化
先日行った実証実験の第1弾では、東急エージェンシー社とともにバーチャルパネルを用いてテレビCMと各種デジタル広告の接触状況を統合的に分析し、媒体横断での重複・純増効果の把握や、効果最大化に向けた広告配分の最適化に関する示唆を得ることができました。
本取り組みに関する詳細は別途近日公開予定です(先行して個別にお知りになりたい方はお問合せ下さい)。
DCR(データクリーンルーム)との使い分け
「本当は異なる企業間で保有するデータをID連携することで複合的に分析したいが、できない」という課題の解決策として、デジタルプラットフォーマーを中心にDCR(データクリーンルーム):匿名化や非識別化を施したうえで安全に異なる企業間のデータ連携を行うという方法も近年広がってきています。
DCRと合成データの違いは、端的にまとめると
・DCRは見えないようにしているが実在しているデータを扱っている
・合成データは、実在しない
という点です。
たとえば以下のようなケースでは、バーチャルパネルの活用が選択肢に入ってくるでしょう。
・2社間で保有するデータ内での"ユーザーの重複"が少なく、DCR内でID連携できる数が限られてしまうことが想定される場合
・デジタル広告の媒体実績レポートや国勢調査の統計データなど、集計済みデータしかなく連携できる「ID」自体が存在しない場合
いかがでしたでしょうか。
合成データは、"実在しない"ので少々とっつきにくく感じられるかもしれません。
ですが、その背景にある考え方を知ると、生成AI活用や開発・研究、マーケティング分析など、さまざまな場面で活用が期待されている理由が見えてきます。
本記事が、皆様の業務における合成データ活用の第一歩となれば幸いです。
【関連コンテンツ】
・2026 / 09 / 29プレスリリース:ID連携不要で実績レポートから広告媒体横断分析を可能とする バーチャルパネル化技術を開発、実証実験を実施~合成データ生成やデータフュージョンを用いた"仮想のパネル"で広告効果最適化を支援~